Di era eksplosif data saat ini, keputusan teknologi yang kita ambil bisa sangat menentukan keberhasilan proyek. Apakah proyek Anda lebih cocok menggunakan pendekatan klasik seperti Machine Learning (ML) atau Anda harus langsung melompat ke Deep Learning (DL)? Memilih yang salah bisa berarti: waktu implementasi yang panjang, biaya yang jauh melebihi benefit, atau hasil yang tak sesuai ekspektasi.
ML dan DL sering kali disebut bergantian, tapi mereka sebenarnya berbeda secara mendasar — dari data yang dipakai, sumber daya komputasi, hingga bagaimana fitur (cirinya) diolah.
Apa Itu Machine Learning?
Definisi & Posisi di dalam AI
Machine Learning adalah bagian dari Artificial Intelligence (AI) yang memungkinkan sistem komputer untuk “belajar” dari data tanpa diprogram secara eksplisit untuk setiap langkahnya.
Karakteristik Utama ML
- Bekerja dengan data terstruktur (tabel, kolom, angka jelas).
- Memerlukan feature engineering (manusia menentukan ciri penting).
- Komputasi relatif ringan; implementasi cepat.
- Mudah diinterpretasi, cocok untuk domain regulasi.
Desain Sistem Machine Learning
Satu gambar yang selalu sangat membantu untuk diingat adalah berikut ini:
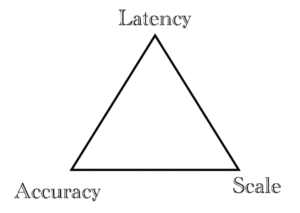
Akurasi, latensi, dan skalabilitas dalam sistem Machine Learning membentuk sebuah segitiga. Kamu cuma bisa mengoptimalkan dua hal sekaligus secara maksimal.
- Kamu bisa punya model yang sangat akurat dan skalabel sampai jutaan entri, tapi pasti nggak akan cepat.
- Kamu bisa punya model yang cepat dan skalabel sampai jutaan entri, tapi akurasinya bakal turun.
- Kamu bisa punya model yang akurat dan cepat, tapi skalabilitasnya jadi kurang bagus.
Pertimbangan ini memang umum banget—nggak tergantung masalah tertentu—tapi tetap penting buat nentuin desain sistem ML yang mau kamu bangun. Kita bakal balik lagi ke topik ini nanti.
Selain itu, kemampuan model sebaiknya sejalan sama ukuran dataset latih. Biasanya kita ingin menghindari kondisi di mana error di data latih turun, tapi error di data uji malah naik (alias overfitting).
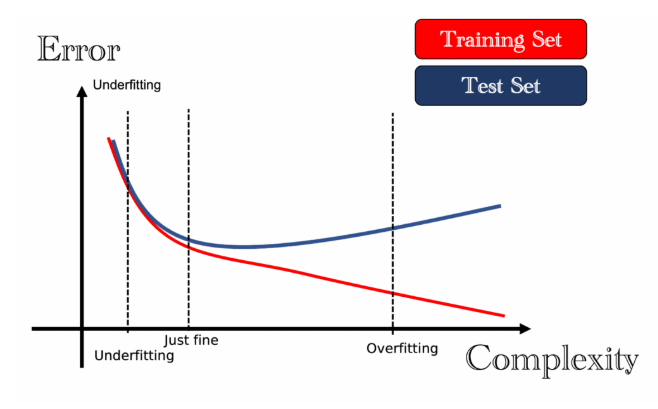
Kita nggak mau berada di area underfitting ataupun overfitting. Ini alasannya:
Secara sederhana, underfitting terjadi waktu model kamu terlalu simpel, sampai-sampai nggak bisa nangkep pola sebenarnya dalam data—kayak mencoba bikin garis lurus untuk pola spiral. Overfitting adalah kebalikannya: model mempelajari data latih terlalu detail, termasuk bagian yang sebenarnya cuma noise. Akibatnya, model tampil bagus di data yang sudah pernah dilihat, tapi buruk waktu menghadapi data baru. Titik idealnya ada di tengah-tengah: model paham struktur datanya tanpa sekadar menghafal.
Contoh aplikasi umum ML
Beberapa contoh klasik:
- Prediksi churn pelanggan: data pelanggan, transaksi historis, transaksi terakhir → ML
- Sistem rekomendasi: berdasarkan aktivitas pengguna dan ciri pengguna (tabular)
- Deteksi fraud dalam transaksi finansial: fitur asal, tujuan, frekuensi → ML
Dengan demikian, ML sering jadi pilihan awal ketika data Anda sudah rapi, terstruktur, dan proyek tidak membutuhkan pengolahan citra/gambar, suara atau teks bebas skala besar.
Apa Itu Deep Learning?
Definisi & hubungan dengan ML
Deep Learning adalah salah satu sub‑kategori dari Machine Learning yang menggunakan jaringan saraf berlapis (artificial neural networks) untuk memproses data. Istilah “deep” mengacu pada banyaknya lapisan (layers) dalam jaringan tersebut, memungkinkan pemodelan pola yang sangat kompleks dan abstrak.
Beberapa arsitektur DL populer:
- Convolutional Neural Network (CNN) → computer vision
- Recurrent Neural Network (RNN) → data berurutan
- Transformer → NLP modern & LLM (ChatGPT, Gemini)
Karakteristik utama DL
- Dapat bekerja dengan data tidak terstruktur: gambar, suara, teks bebas.
- Feature engineering secara otomatis: model “belajar” sendiri fitur penting dari data tanpa intervensi manusia intensif.
- Membutuhkan komputasi besar: GPU/TPU, banyak data, waktu pelatihan panjang.
- Hasilnya bisa sangat akurat pada domain kompleks – tapi interpretabilitasnya bisa rendah (“black box”).
Contoh aplikasi umum DL
- Pengolahan citra: pengenalan objek, deteksi tumor medis
- Pengolahan suara dan bahasa: asisten suara, terjemahan otomatis
- Mobil otonom: deteksi rintangan, pemahaman lingkungan
DL adalah pilihan ketika kompleksitas tugas dan modality data Anda melampaui apa yang dapat ditangani dengan mudah oleh ML tradisional.
Kelebihan DL: akurasi tinggi, mampu memproses data tidak terstruktur (gambar, audio, teks).
Kekurangan DL: butuh GPU/TPU, dataset besar, dan waktu training lebih lama.
ML vs Deep Learning: Perbedaan Utama
Data & kompleksitas fitur
- ML unggul ketika data terstruktur, fitur jelas. DL unggul ketika data besar dan tidak terstruktur (gambar, suara, teks).
- Dalam ML, manusia memilih fitur; dalam DL, model belajar sendiri fitur abstrak.
Kebutuhan komputasi & waktu pelatihan
- ML: CPU cukup, pelatihan bisa cepat; DL: membutuhkan GPU/TPU, pelatihan bisa butuh waktu lama dan sumber daya besar.
- Data yang diperlukan DL bisa jauh lebih besar agar performa superior.
Interpretabilitas & kecepatan implementasi
- ML: Model yang lebih sederhana → lebih mudah dipahami (“mengapa prediksi ini?”)
- DL: Jaringan berlapis mempersulit interpretasi, membuatnya kurang ideal untuk domain yang regulasi tinggi.
Skalabilitas & akurasi
- ML cukup jika skala proyek sedang, kompleksitas terbatas.
- DL mulai masuk ketika skala besar, pola sangat kompleks dan keuntungan akurasi tinggi dapat menjustifikasi biaya.
Singkatnya: bukan soal “DL selalu lebih baik”, tapi soal “metode mana yang paling tepat untuk konteks Anda”.
Kapan Harus Menggunakan ML vs Deep Learning?
Situasi ideal untuk ML
Kamu sebaiknya memilih ML ketika:
- Dataset relatif kecil atau ukuran sedang — ribuan hingga puluhan ribu rekaman.
- Data terstruktur: tabel, kolom, transaksi jelas.
- Fitur dapat ditentukan secara manual oleh domain expert.
- Sumber daya komputasi terbatas atau waktu untuk implementasi terbatas.
- Anda butuh model yang dapat dijelaskan (interpretabilitas tinggi) untuk domain seperti keuangan, audit, regulasi.
Situasi ideal untuk DL
Kamu sebaiknya memilih DL ketika:
- Dataset sangat besar—ratusan ribu hingga jutaan contoh—dan/atau data tidak terstruktur (gambar, teks, suara).
- Fitur sulit atau sangat banyak untuk didefinisikan secara manual.
- Anda memiliki sumber daya komputasi yang kuat dan waktu pelatihan cukup.
- Akurasi dan performa sangat penting — misalnya pengenalan citra medis atau analisis video real‑time.
Decision‑tree cepat dalam memilih
- Apakah datamu gambar/teks/katakanlah un‑terstruktur? → leaning ke DL
- Apakah datamu terstruktur, fitur jelas, dan sumber daya terbatas? → leaning ke ML
- Apakah interpretasi hasil sangat penting? Jika ya, ML bisa lebih cocok
- Apakah kamu punya anggaran besar dan butuh akurasi maksimal? Jika ya, pertimbangkan DL
Catatan praktis & pertimbangan bisnis
- Biaya: DL bisa jauh lebih mahal (hardware, dataset besar, waktu)
- Waktu ke nilai (time‑to‑value): ML bisa lebih cepat di‑deploy
- Skill tim: Apakah tim kamu familiar dengan DL dan operasi GPU?
- Pemeliharaan: DL sering butuh pemeliharaan lebih kompleks
- ROI: Eksekusi ML sederhana dengan kebutuhan moderat sering menghasilkan ROI lebih cepat
Temukan juga artikel terkait perbedaan AI vs Machine Learning vs Pemrograman Tradisional
Contoh Kasus
Kasus ML: Prediksi Churn Pelanggan di E‑commerce
Skenario: Sebuah perusahaan e‑commerce ingin mengurangi tingkat churn pelanggan (pelanggan yang berhenti menggunakan layanan) untuk mempertahankan pendapatan.
Data: Data transaksi pelanggan (jumlah pembelian, frekuensi kunjungan, nilai pembelian, demografis, jenis pelanggan) — terstruktur.
Solusi: Menggunakan ML seperti Random Forest untuk klasifikasi churn.
Mengapa ML cocok:
- Data dalam bentuk tabel dengan fitur yang dapat ditentukan (misalnya: total transaksi 3 bulan terakhir, rata‑rata nilai pembelian, jenis loyalitas)
- Sumber daya terbatas, tim sudah familiar dengan algoritma seperti Random Forest, Logistic Regression
- Interpretabilitas penting: manajemen ingin tahu kenapa pelanggan bisa berhenti — model ML bisa memaparkan fitur penting
Implementasi singkat: - Feature engineering: buat fitur‑fitur seperti “total pembelian 90 hari terakhir”, “waktu sejak pembelian terakhir”
- Pilih algoritma ML: misalnya Gradient Boosting atau Random Forest
- Evaluasi: metrik AUC, recall untuk churn
- Hasil: model dipakai untuk mengidentifikasi pelanggan berisiko tinggi, kemudian tim retention memfokuskan kampanye untuk mereka
Mengapa tidak DL: Karena data tidak un‑terstruktur, kebutuhan akurasi ekstra besar tidak ada, dan interpretasi fitur penting.
Contoh kode Python (Scikit-Learn)
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report


# Dataset sintetis
data = {
'total_transaksi': [100, 20, 45, 10, 95, 5, 75, 23, 87, 2],
'rata_rata_transaksi': [10, 2, 5, 1, 9.5, 0.5, 8.3, 2.3, 9.1, 0.3],
'frekuensi_kunjungan': [30, 5, 10, 3, 25, 2, 20, 4, 28, 1],
'churn': [0, 1, 0, 1, 0, 1, 0, 1, 0, 1]
}


# Dataframe
df = pd.DataFrame(data)
X = df.drop('churn', axis=1)
y = df['churn']


# Split data
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)


# Latih model
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)


# Evaluasi
y_pred = model.predict(X_test)
print(classification_report(y_test, y_pred))Kasus DL: Deteksi Tumor dari Citra Medis
Skenario: Menggunakan CNN untuk mengidentifikasi tumor dalam gambar medis.
Contoh Kode Python (Keras + TensorFlow)
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Conv2D, MaxPooling2D, Flatten, Dense


# Model CNN sederhana
model = Sequential([
Conv2D(32, (3,3), activation='relu', input_shape=(64, 64, 3)),
MaxPooling2D(pool_size=(2,2)),
Conv2D(64, (3,3), activation='relu'),
MaxPooling2D(pool_size=(2,2)),
Flatten(),
Dense(128, activation='relu'),
Dense(1, activation='sigmoid')
])


# Kompilasi model
model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])


# Asumsikan data gambar sudah tersedia dalam format image_generator
# model.fit(train_generator, epochs=10, validation_data=val_generator)Model ini dapat digunakan untuk dataset gambar medis yang sudah diberi label (misalnya CT-scan tumor vs non-tumor)
Cara Menentukan Pilihan Teknologi
Audit Data Anda
- Tentukan jumlah data: apakah cukup besar untuk DL?
- Cek jenis data: terstruktur atau tidak terstruktur?
- Periksa kualitas data: missing values, outlier, anotasi (jika gambar/teks)
- Evaluasi waktu dan budget: apakah cukup untuk proyek DL?
Tentukan Tujuan Bisnis & Teknis
- Apakah yang paling penting: kecepatan ke pasar (time‑to‑value) atau akurasi maksimal?
- Seberapa penting interpretabilitas hasil? (Contoh: regulasi keuangan/medis)
- Apakah pengembangan dan pemeliharaan model masuk ke dalam operasional?
Benchmark Sederhana dengan ML Dahulu
- Jika data Anda memungkinkan, mulai dengan ML sebagai baseline.
- Latih model sederhana, ukur performa, interpretasi, scalability.
- Jika performa sudah memadai → gunakan ML dan sempurnakan.
Jika Data/Persyaratan Kompleks → Pertimbangkan DL
- Jika ML tidak cukup akurat atau data sangat besar/unstructured → masuk ke DL.
- Rancang dengan baik: arsitektur, hardware, pipeline, monitoring.
Monitor dan Evaluasi – Mungkin Hybrid
- Setelah model di‑deploy, pantau performa.
- Bisa jadi diperlukan kombinasi : ML + DL (misal ML fitur terstruktur + DL untuk data gambar).
- Pertimbangkan upgrade atau transfer learning untuk DL agar efisien.
Dengan mengikuti panduan ini, Anda meminimalkan risiko memilih teknologi yang salah dan mendapatkan hasil yang optimal dari segi biaya, waktu, dan hasil.
Tantangan & Tren ke Depan
Tantangan
- Kebutuhan data besar untuk DL dan biaya tinggi (hardware, energi, waktu)
- Interpretabilitas DL yang rendah membuat banyak organisasi ragu untuk adopsi di domain regulasi tinggi
- Pengembangan dan pemeliharaan model sering memerlukan skill khusus yang belum dimiliki banyak tim
- Risiko overfitting atau underspecification (terlalu spesifik ke data latih) — penelitian menunjukkan DL pun bisa mengalami masalah generalisasi.
Tren ke Depan
- Hybrid Model: Kombinasi ML klasik + DL untuk memaksimalkan kelebihan masing‑masing.
- AutoML: Alat otomatis yang membantu memilih algoritma dan hyper‑parameter secara otomatis, mengurangi skill yang diperlukan.
- Transfer Learning & model pre‑trained: Menggunakan model DL yang sudah dilatih untuk domain umum, lalu menyesuaikan ke domain spesifik Anda.
- Edge Computing & model ringan: DL yang bisa dijalankan di perangkat edge dengan resource terbatas.
- Fokus interpretabilitas: Teknik seperti SHAP, LIME makin penting agar DL bisa diterima di domain yang butuh “penjelasan”.
Kesimpulan
ML dan DL bukanlah “kompetitor” yang satu harus menggantikan yang lain — melainkan alat yang berbeda untuk kebutuhan berbeda. Intinya:
- Gunakan ML ketika data Anda terstruktur, fitur bisa dibuat secara manual, dan interpretasi penting.
- Gunakan DL ketika Anda punya data besar/unstructured, fitur kompleks, dan sumber daya memadai.
- Evaluasi kebutuhan bisnis Anda, bukan sekedar keinginan “pakai teknologi terkini”.
- Mulai sederhana, ukur, lalu tingkatkan bila perlu — jangan lompat ke DL hanya karena hype.
Dengan pemilihan metodologi yang tepat, Anda akan mendapatkan hasil terbaik dari sisi biaya, waktu, dan performa.
FAQ (Sering Ditanya)
Tidak selalu. DL memang sangat powerful di domain tertentu, tetapi ML tetap akan sangat relevan untuk banyak kasus yang lebih sederhana atau ketika interpretabilitas penting.
Tidak ada angka pasti universal, tapi ketika Anda memiliki puluhan ribu hingga jutaan contoh dan data tidak terstruktur (gambar, teks), maka keuntungan DL mulai muncul.
Ya. Banyak sistem menggunakan kombinasi: ML untuk data terstruktur + DL untuk gambar atau teks. Atau ML sebagai baseline, DL sebagai upgrade.
Risiko termasuk biaya yang tak perlu besar, waktu implementasi melambat, hasil kurang optimal, atau model sulit dipahami oleh stakeholder.
Machine Learning, karena lebih ringan, cepat, dan mudah diimplementasikan.
Referensi :