
Mengapa Mean Absolute Error (MAE) Krusial untuk Model Regresi
Saat kita membangun model machine learning, salah satu tahap krusial adalah evaluasi. Di sinilah kita mengetahui kualitas dan performa model. Namun, sering terjadi kebingungan mendasar, terutama dalam membedakan metrik untuk tugas klasifikasi dan regresi.
Kesalahan umum bagi pemula adalah terlalu fokus pada ‘akurasi’ (accuracy). Padahal, akurasi adalah metrik yang sangat baik untuk tugas klasifikasi (misalnya, membedakan email spam atau bukan), tapi sama sekali tidak relevan untuk model regresi.
Mengapa Akurasi Gagal dalam Regresi?
Model regresi memiliki tugas untuk memprediksi angka (nilai kontinu), bukan menebak kategori. Contohnya, memprediksi harga rumah, memperkirakan suhu, atau menghitung estimasi konsumsi listrik.
Untuk tugas ini, kita tidak bertanya, “Apakah prediksinya benar atau salah?” Pertanyaan yang tepat adalah, “Seberapa jauh prediksinya dari nilai aslinya?”
Di sinilah metrik evaluasi error seperti Mean Absolute Error (MAE) menjadi pilihan utamanya.
Mengenal MAE: Metrik yang Jujur dan Mudah Dipahami
MAE adalah salah satu metrik paling fundamental dan sering digunakan untuk evaluasi model regresi. Sederhananya, MAE menghitung rata-rata dari selisih absolut (nilainya selalu positif) antara nilai prediksi Anda dan nilai observasi aslinya.
Keunggulan MAE adalah metrik ini sangat mudah diinterpretasikan dan sangat relevan dengan konteks di dunia nyata.
Perspektif dari Para Ahli
Dua referensi utama di dunia data science juga menegaskan pentingnya MAE:
- Scikit-Learn (Pustaka Standar): Dokumentasi resmi Scikit-Learn, yang telah menjadi panduan wajib bagi praktisi ML di Python, mendefinisikan MAE dengan jelas.Kutipan: “Metrik [MAE] ini adalah rata-rata dari kesalahan absolut… Metrik ini paling baik digunakan ketika mengukur performa pada data (set tes) yang tidak digunakan untuk melatih model.” — Scikit-Learn Developers, “Mean absolute error,” scikit-learn.org, 2023.
- Aurélien Géron (Pakar di Bidangnya): Dalam buku “Hands-On Machine Learning” (buku panduan yang sangat populer), ahlinya menggarisbawahi sifat MAE yang intuitif.Kutipan: “Mean Absolute Error… sangat lugas: ia hanya menghitung rata-rata dari kesalahan absolut… Keuntungan utamanya adalah ia paling mudah untuk diinterpretasikan karena hasilnya berada dalam skala yang sama dengan nilai target.” — Géron, A., “Hands-On Machine Learning with Scikit-Learn, Keras & TensorFlow,” 2nd ed., O’Reilly, 2019.
Pengalaman Praktis: Arti Sebenarnya dari MAE
Dalam penerapan di dunia kerja, kejelasan MAE ini menjadi sangat krusial. Bayangkan Anda membangun model prediksi harga rumah dan model Anda memiliki MAE Rp 50.000.000.
Artinya sangat jelas: secara rata-rata, prediksi model Anda meleset (bisa lebih tinggi atau lebih rendah) sebesar 50 juta rupiah.
Interpretasi yang lugas ini membantu rekan non-teknis (seperti manajer produk atau klien) untuk segera memahami seberapa baik performa model Anda dan apa risikonya.
Poin Pembahasan di Artikel Ini
Agar Anda semakin mahir dalam evaluasi model, artikel ini akan menjadi panduan lengkap untuk menguasai MAE. Kita akan membahas:
- Mengapa Mean Absolute Error (MAE) Krusial untuk Model Regresi
- Poin Pembahasan di Artikel Ini
- Apa Itu MAE (Mean Absolute Error)?
- Kapan Sebaiknya Kamu Menggunakan MAE?
- Kapan Sebaiknya Menghindari MAE?
- Cara Menghitung MAE Secara Manual
- Menghitung MAE Menggunakan Scikit-Learn (Sklearn)
- MAE vs MSE vs RMSE: Mana Lebih Baik?
- Kesalahan Umum dalam Menggunakan MAE
- FAQ: Pertanyaan Umum tentang MAE
- Kesimpulan
Apa Itu MAE (Mean Absolute Error)?
Mean Absolute Error (MAE) adalah metrik evaluasi regresi yang mengukur rata-rata selisih absolut antara nilai prediksi dan nilai aktual.
Secara matematis:
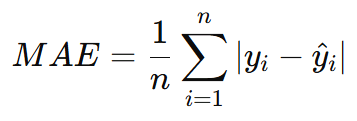
Artinya, MAE menunjukkan seberapa jauh (secara rata-rata) prediksi model dari nilai asli dalam satuan yang sama.
Contoh:
Jika MAE = 5, artinya model rata-rata meleset 5 satuan dari nilai sebenarnya. Jika prediksi harga rumah, maka model meleset 5 juta atau 5 ribu tergantung satuan harga.
Kelebihan MAE
- Mudah diinterpretasikan karena memakai skala asli.
- Tidak terlalu sensitif terhadap outlier (dibanding MSE).
Kekurangan MAE
- Gradient tidak smooth → kadang kurang pas untuk deep learning.
- Tidak menghukum error besar sekeras MSE.
Kapan Sebaiknya Kamu Menggunakan MAE?
Namun, pertanyaan lanjutannya adalah: di antara banyaknya metrik evaluasi, kapan MAE menjadi pilihan yang paling tepat?
Memilih metrik evaluasi bukanlah sekadar “asal pilih”. Pilihan kamu akan sangat memengaruhi bagaimana kamu menilai performa model dan keputusan apa yang akan kamu ambil selanjutnya. Di dunia regresi, “rival” utama MAE adalah RMSE (Root Mean Squared Error). Pilihan antara MAE dan RMSE seringkali bergantung pada satu hal krusial: bagaimana kamu ingin memperlakukan outlier atau kesalahan besar.
Berdasarkan pengalaman praktis, MAE adalah pilihan terbaik dalam skenario berikut:
1. Ketika Outlier Dianggap “Anomali” atau “Noise” Bayangkan kamu memprediksi penjualan harian sebuah toko. Tiba-tiba, ada satu hari di mana sistem offline dan penjualan tercatat nol (padahal seharusnya tidak). Atau sebaliknya, ada event diskon besar-besaran yang membuat penjualan melonjak 500%.
Jika kamu menganggap data-data ekstrem ini adalah “gangguan” yang tidak mewakili bisnis normal dan tidak ingin satu hari aneh ini membuat seluruh evaluasi model kamu terlihat buruk, MAE adalah pilihan yang tepat.
2. Ketika Kamu Menginginkan Interpretasi yang Paling Sederhana Seperti yang dibahas sebelumnya, MAE memiliki interpretasi paling lugas. “Secara rata-rata, model kami meleset sebesar 5 Juta Rupiah.” Ini adalah kalimat yang sangat mudah dipahami oleh rekan non-teknis atau pemangku kepentingan.
Meskipun RMSE juga memiliki unit yang sama, besaran nilainya (yang cenderung lebih tinggi dari MAE) terkadang lebih sulit untuk dijelaskan secara intuitif.
Gunakan MAE Saat :
| Kapan Menggunakan MAE | Penjelasan |
|---|---|
| Dataset memiliki skala dunia nyata | Contoh: harga rumah, suhu, penjualan. |
| Ingin interpretasi yang mudah dipahami pengguna bisnis | MAE bisa dijelaskan ke stakeholder tanpa rumus rumit. |
| Terdapat outlier ringan | MAE lebih stabil dibanding MSE. |
| Evaluasi time-series forecasting | MAE sering dipakai untuk memprediksi permintaan, penjualan, atau cuaca. |
| Gunakan MAE sebagai baseline untuk membandingkan model regresi | MAE mudah dijadikan benchmark apakah model baru lebih baik atau tidak. |
Kapan Sebaiknya Menghindari MAE?
Penting untuk bersikap jujur: MAE tidak selalu menjadi pilihan terbaik.
Hindari MAE (dan gunakan RMSE) ketika sebuah kesalahan besar jauh lebih merugikan daripada banyak kesalahan kecil.
Bayangkan kamu memprediksi permintaan daya di pembangkit listrik.
- Meleset 10 MW sebanyak 50 kali (total 500 MW) itu tidak ideal.
- Tapi, meleset 500 MW sekali saja bisa menyebabkan pemadaman listrik total.
Dalam kasus ini, kamu ingin metrik evaluasi kamu sangat sensitif terhadap kesalahan besar. Kamu ingin model “dihukum” berat jika melakukan kesalahan fatal. Di sinilah RMSE lebih unggul.
Temukan juga Bagaimana peran Precision dan Recall dalam Machine Learning
Cara Menghitung MAE Secara Manual
Studi Kasus Sederhana: Prediksi Harga Kos
Bayangkan kamu membuat model regresi sederhana untuk memprediksi harga sewa kos bulanan di sebuah kota, berdasarkan fitur tertentu (misal: luas kamar). Kamu memiliki 5 data uji untuk mengetes model kamu.
| Kamar Kos | Harga Asli (y) | Harga Prediksi Model (y^) |
|---|---|---|
| Kos A | Rp 1.5 Juta | Rp 1.7 Juta |
| Kos B | Rp 1.3 Juta | Rp 1.2 Juta |
| Kos C | Rp 2.0 Juta | Rp 1.8 Juta |
| Kos D | Rp 1.8 Juta | Rp 1.8 Juta |
| Kos E | Rp 1.6 Juta | Rp 2.0 Juta |
Sekarang, mari kita hitung MAE-nya langkah demi langkah.
Langkah 1: Hitung Error (Selisih) untuk Setiap Data
Langkah pertama adalah mencari tahu seberapa jauh melesetnya prediksi kita untuk setiap kamar kos. Kita sebut ini Error atau selisih (y - y^).
- Kos A: 1.5 – 1.7 = -0.2
- Kos B: 1.3 – 1.2 = 0.1
- Kos C: 2.0 – 1.8 = 0.2
- Kos D: 1.8 – 1.8 = 0.0
- Kos E: 1.6 – 2.0 = -0.4
Langkah 2: Ambil Nilai Absolut dari Error
Di sinilah bagian “A” (Absolute) dari MAE berperan. Kita tidak peduli apakah tebakan kita terlalu tinggi (negatif) atau terlalu rendah (positif). Kita hanya peduli seberapa jauh selisihnya. Untuk itu, kita ubah semua nilai negatif menjadi positif (nilai absolut).
- Kos A: |-0.2| = 0.2
- Kos B: |0.1| = 0.1
- Kos C: |0.2| = 0.2
- Kos D: |0.0| = 0.0
- Kos E: |-0.4| = 0.4
Langkah 3: Jumlahkan Semua Absolute Error (Σ)
Sekarang, kita jumlahkan semua hasil dari Langkah 2. Ini adalah bagian ∑ (Sigma) dari rumus.

Langkah 4: Hitung Rata-ratanya (Mean)
Terakhir, kita bagi dengan jumlah data n. Di sini, n = 5. Ini adalah bagian 1/n dari rumus MAE.

MAE = Total Absolute Error / n MAE = 0.9 / 5 MAE = 0.18
Interpretasi Hasil
Kita mendapatkan nilai MAE sebesar 0.18.
Apa artinya ini? Karena data kita dalam satuan “Juta Rupiah”, ini berarti: “Secara rata-rata, model prediksi harga kos kamu meleset sebesar 0.18 Juta Rupiah, atau Rp 180.000, dari harga sebenarnya.”
Lihat? Dengan membedahnya secara manual, kamu bisa tahu persis dari mana angka itu berasal dan apa maknanya dalam konteks dunia nyata.
Menghitung MAE Menggunakan Scikit-Learn (Sklearn)
Scikit-learn menyediakan fungsi bawaan:
from sklearn.metrics import mean_absolute_error

y_true = [10, 15, 20, 25, 30]
y_pred = [12, 14, 18, 28, 27]

mae = mean_absolute_error(y_true, y_pred)
print("MAE:", mae)Untuk model regresi:
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)

model = LinearRegression()
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
mae = mean_absolute_error(y_test, y_pred)
print("MAE:", mae)
Sklearn mempermudah evaluasi model secara otomatis.
Studi Kasus: Menghitung MAE untuk Prediksi Harga Rumah
Misalkan dataset:
from sklearn.datasets import load_boston
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error

data = load_boston()
X = data.data
y = data.target

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)

model = LinearRegression()
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
mae = mean_absolute_error(y_test, y_pred)

print("MAE Harga Rumah:", mae)
Interpretasi:
Jika MAE = 3.5, artinya prediksi harga rumah rata-rata meleset 3.5 ribu dolar.
Dalam bisnis properti, ini termasuk error yang cukup baik tergantung skala harganya.
MAE vs MSE vs RMSE: Mana Lebih Baik?
| Metrik | Kelebihan | Kekurangan | Kapan digunakan |
|---|---|---|---|
| MAE | Mudah dipahami, stabil | Tidak menghukum outlier besar | Data real-world biasa |
| MSE | Menghukum error besar | Tidak intuitif | Saat butuh penalti besar |
| RMSE | Interpretasi skala besar | Lebih rumit | Time-series & error besar |
Ringkasan:
- Gunakan MAE → interpretasi simpel.
- Gunakan MSE → ingin penalti besar untuk error ekstrem.
- Gunakan RMSE → time series & error besar.
Kesalahan Umum dalam Menggunakan MAE
- Menggunakan MAE tanpa melihat distribusi error
Kadang distribusi error miring. - Tidak menormalisasi data ketika dataset besar
Skala besar = MAE besar pula. - Menilai model hanya dengan MAE
Selalu bandingkan juga dengan MSE, RMSE, R2. - Mengabaikan unit skala data
MAE harga rumah berbeda skala dengan MAE suhu. - Menggunakan MAE pada data dengan noise ekstrem
RMSE lebih cocok jika error ekstrem adalah faktor penting.
FAQ: Pertanyaan Umum tentang MAE
“tergantung” MAE yang “baik” adalah MAE yang secara signifikan lebih rendah dari baseline kamu dan cukup rendah untuk bisa diterima oleh kebutuhan bisnis. “Jika skala harga 100–500, MAE 10 sudah cukup baik.”
Ya. Dengan asumsi semua hal lain sama (misalnya, kamu menggunakan data uji yang sama), nilai MAE yang lebih rendah secara objektif lebih baik. Itu berarti, secara rata-rata, jarak antara prediksi model kamu dan nilai aslinya semakin kecil.
Tidak akan pernah. Secara matematis, nilai RMSE akan selalu sama dengan atau lebih besar dari MAE (RMSE ≥ MAE).
Lebih stabil dibanding MSE.
Ya, MAE salah satu metrik terbaik untuk forecasting.
Bisa, tetapi gradient-nya kurang smooth dibanding MSE.
Tidak. Digunakan khusus untuk regresi.
Kesimpulan
MAE adalah salah satu metrik evaluasi regresi paling sederhana dan paling sering digunakan.
Dengan Python, MAE dapat dihitung dengan berbagai cara mulai dari manual menggunakan NumPy hingga otomatis menggunakan Scikit-Learn.
MAE cocok untuk regresi real-world, analisis bisnis, dan perbandingan performa model.
Untuk hasil evaluasi paling akurat, gunakan MAE bersamaan dengan MSE, RMSE, dan R².
Referensi dan Sumber Eksternal
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras & TensorFlow (2nd ed.). O’Reilly Media, Inc.
- Scikit-Learn Developers. (2023).
sklearn.metrics.mean_absolute_error. Diakses dari https://scikit-learn.org/stable/modules/generated/sklearn.metrics.mean_absolute_error.html - Chai, T., & Draxler, R. R. (2014). Root mean square error (RMSE) or mean absolute error (MAE)? — Arguments, analysis and examples. Geoscientific Model Development, 7(3), 1247–1250.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras & TensorFlow (2nd ed.). O’Reilly Media, Inc.